Dùng proxy để thu thập dữ liệu (web scraping) hiệu quả và tuân thủ pháp luật
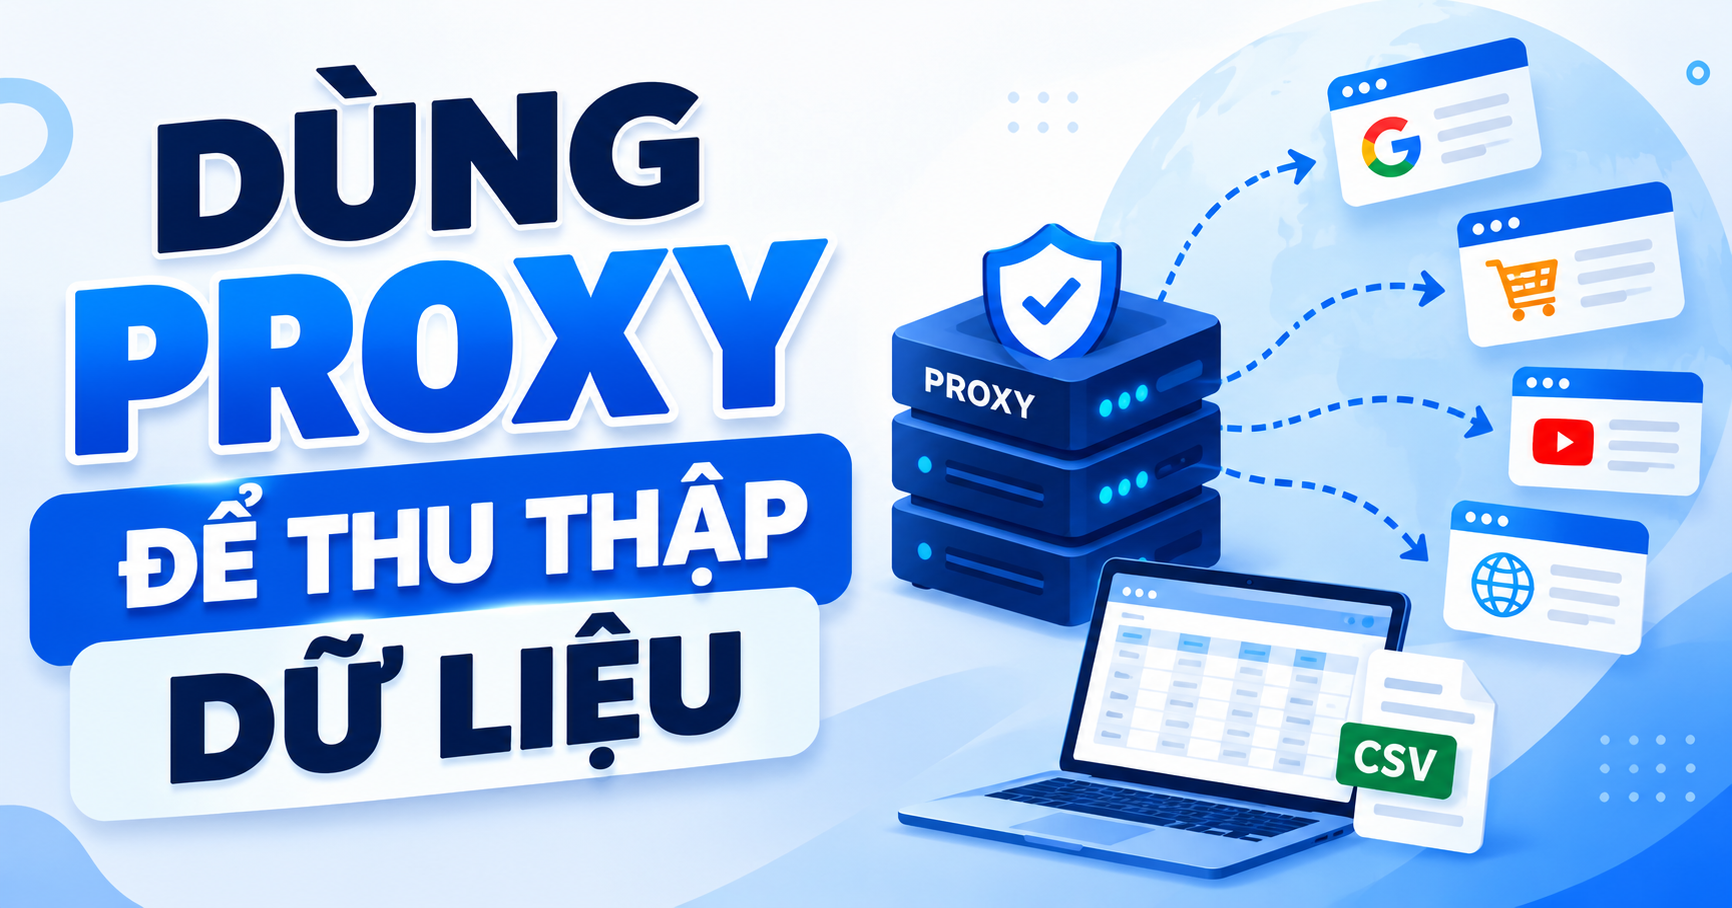
1. Vai trò của proxy trong hoạt động thu thập dữ liệu web (web scraping)
Trong thời đại số, dữ liệu là tài sản vô giá giúp doanh nghiệp phân tích thị trường, nghiên cứu đối thủ và tối ưu hóa chiến lược kinh doanh. Tuy nhiên, khi thực hiện cào dữ liệu (web scraping) với tần suất lớn từ một địa chỉ IP duy nhất, hệ thống bảo mật của website mục tiêu sẽ nhanh chóng nhận diện hành vi bất thường và tiến hành chặn (block) IP đó.
Sử dụng proxy để thu thập dữ liệu là giải pháp kỹ thuật đóng vai trò làm cầu nối trung gian. Bằng cách phân tách và điều hướng các yêu cầu (request) qua nhiều IP khác nhau, hệ thống giúp che giấu IP gốc, phân phối tải trọng truy cập mượt mà và đảm bảo tiến trình thu thập dữ liệu diễn ra liên tục mà không bị gián đoạn.
2. Các loại proxy tối ưu cho việc cào dữ liệu tự động
Tùy thuộc vào quy mô dự án và cấu trúc bảo mật của trang web đích, việc lựa chọn loại proxy phù hợp quyết định trực tiếp đến tỷ lệ cào dữ liệu thành công.
Proxy dân cư (Residential Proxy)
Đây là các địa chỉ IP được cấp bởi nhà mạng viễn thông (ISP) cho người dùng cá nhân.
Ưu điểm: Độ tin cậy cực kỳ cao, gần như không thể bị phát hiện bởi các hệ thống chống bot hiện đại như Cloudflare hay Akamai.
Phù hợp: Cào dữ liệu ở các website thương mại điện tử hoặc các nền tảng có cơ chế kiểm soát truy cập nghiêm ngặt.
Proxy trung tâm dữ liệu (Datacenter Proxy)
Được phát sinh từ các máy chủ đám mây hoặc trung tâm dữ liệu.
Ưu điểm: Tốc độ truy xuất nhanh, băng thông không giới hạn và chi phí tối ưu.
Phù hợp: Cào dữ liệu số lượng lớn trên các trang tin tức hoặc hệ thống không cài đặt bộ lọc chống bot quá phức tạp.
Proxy xoay vòng (Rotating Proxy)
Hệ thống tự động thay đổi địa chỉ IP sau mỗi request hoặc theo khoảng thời gian tùy chỉnh.
Ưu điểm: Giúp tự động hóa hoàn toàn việc luân chuyển IP, loại bỏ rủi ro bị khóa IP hàng loạt khi crawl dữ liệu quy mô lớn.
Để đảm bảo hiệu suất vận hành ổn định và sở hữu nguồn IP sạch, chất lượng cao, bạn có thể tham khảo các giải pháp hạ tầng mạng uy tín tại ProxyZing.Com – nơi cung cấp đa dạng các gói proxy dân cư và datacenter đáp ứng trọn vẹn cho nhu cầu thu thập dữ liệu chuyên nghiệp.
3. Nguyên tắc tuân thủ pháp luật và đạo đức khi dùng proxy cào dữ liệu
Việc sử dụng proxy để thu thập dữ liệu (web scraping) cần được thực hiện trong khuôn khổ pháp lý minh bạch và tuân thủ các chuẩn mực đạo đức trên môi trường mạng.
Đọc kỹ và tuân thủ Điều khoản dịch vụ (ToS): Trước khi triển khai scraper, hãy kiểm tra quy định của website mục tiêu và tệp
robots.txtđể biết những vùng dữ liệu nào cho phép hoặc cấm truy cập tự động.Bảo vệ dữ liệu cá nhân: Không thực hiện cào hoặc lưu trữ trái phép các thông tin nhận dạng cá nhân (PII) khi chưa có sự đồng ý của chủ thể, đảm bảo tuân thủ Luật An ninh mạng và các quy định về bảo vệ dữ liệu cá nhân.
Tránh gây quá tải máy chủ (Anti-DDoS): Tốc độ cào quá dồn dập có thể làm nghẽn hạ tầng của bên bị cào. Cần thiết lập khoảng dừng (delay) hợp lý giữa các request để duy trì sự tôn trọng đối với tài nguyên máy chủ đối phương.
Tôn trọng bản quyền nội dung: Dữ liệu thu thập chỉ nên phục vụ mục đích phân tích, lưu trữ nội bộ hoặc nghiên cứu; tuyệt đối không sao chép nguyên bản để kinh doanh hoặc xuất bản lại trái phép.
4. Bỏ túi kinh nghiệm cấu hình hệ thống web scraping mượt mà
Để tối ưu hóa quá trình thu thập dữ liệu khi kết hợp với hạ tầng từ ProxyZing.Com, bạn nên áp dụng các kỹ thuật bổ trợ sau:
Xoay vòng User-Agent và Header: Không chỉ thay đổi IP, hãy xoay cả các thông tin trình duyệt (User-Agent, Accept-Language) để giả lập chính xác hành vi của người dùng thực.
Tự động xử lý mã lỗi: Thiết lập cơ chế bắt mã trạng thái HTTP như 429 (Too Many Requests) hoặc 403 (Forbidden) để hệ thống tự động ngắt kết nối tạm thời hoặc đổi sang IP proxy mới ngay lập tức.
Kiểm soát thời gian giữa các truy cập (Throttling): Áp dụng thời gian chờ ngẫu nhiên (Random Delay) giữa các lượt gửi yêu cầu để giảm thiểu sự chú ý từ hệ thống phát hiện hành vi bất thường.